机器学习基础:从概念到线性回归与梯度下降实战
本文深入浅出地介绍了机器学习的基本概念,通过对比传统算法与机器学习算法,详细阐述了线性回归模型、均方误差损失函数及梯度下降优化过程,并提供了Python实战代码。
- 机器学习
- 人工智能
机器学习
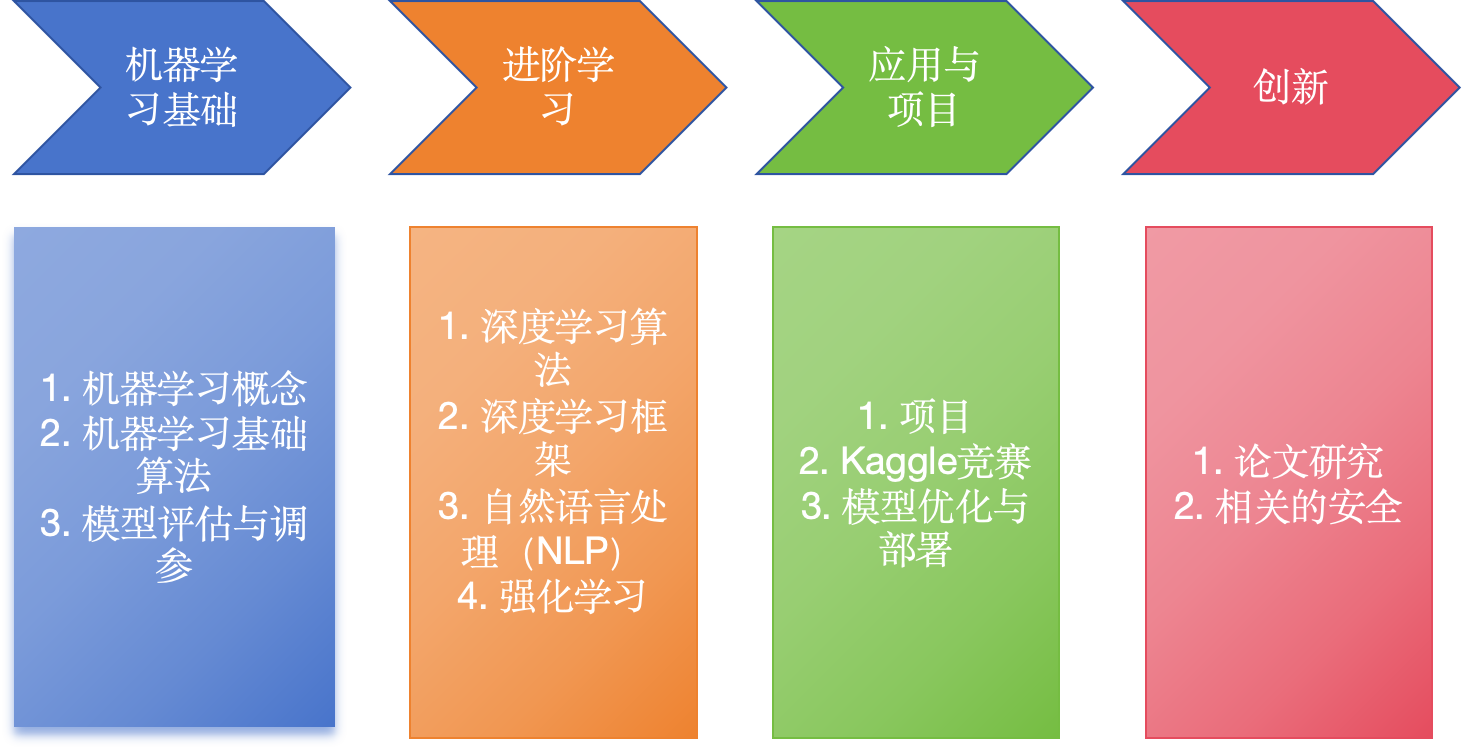
机器学习基础
前记:
机器学习是一种使用数字去揭示规律的算法思想。需要比较强的矩阵运算思维,接下来记录个人学习思路。
机器学习基本概念
数据从输入到输出的一系列出入过程称作算法,也可以认为是一系列公式的组合。那么机器学习算法和普通的算法区别在于前者的算法过程并不是写好的,是可以在算法执行过程中发生改变的。那么发生改变的是什么呢?举个例子:
对于公式,自变量是,因变量是,那么这里有两个未知数和,这里我们给出两组数,,如何去求这两个未知数呢?我们用普通算法和机器学习算法解决一下:
普通算法
我们带入,得到一个方程组
\begin{cases}\begin{align}4 = 2a +b \tag{1}\\ 6 = 3a + b\tag{2}\end{align}\end{cases}
化简方程组得到
\begin{cases}\begin{align}b = 4-2a\tag{3}&&\\ 6 = 3a + b \tag{4}\end{align}\end{cases}
将(3)中的方程带入中,得到方程,简化后得到
\begin{align} a = 2 \tag{5}\end{align}。
最后将带中得到
总结这个过程,得到我们的算法,对于有:,即
最后,我们将算法使用代码实现。
formula = input("输入数据(格式:(a,b)): ")

datas = formula.split(" ")

k = 0
x = []
y = []
for data in datas:
    for i in range(len(data)):
        if data[i] == "(":
            x.append(data[i + 1])
        if data[i] == ")":
            y.append(data[i - 1])
    k += 1

a = (int(y[1]) - int(y[0])) / (int(x[1]) - int(x[0]))
b = int(y[0]) - int(x[0]) * a

print(a, b)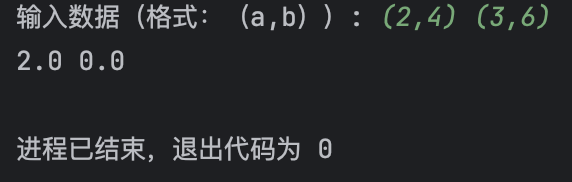
机器学习算法:
通过上面的算法可以看出,我们需要经过一系列推导才能写出对应的代码。如果我们不需要推导,而是直接假设,一开始随机赋值给,之后,根据给出的数据,进一步优化的值,使得根据以及x计算出来的越来越接近,甚至完全符合给定的。这样我们可能就找到了想要的的值。
很显然,我们的目的就是寻找一个正确的的值,能够正确映射 (我们把每一个数据对举例) 之间的关系。我们现在不想推理 或者假设我们推理不出来,我们想找规律那样,根据数据去找到对应的,这里我们称a,b为权重或者参数
那么问题来了,如何优化呢?
优化就是我们要找一个指标,让这个指标朝着更好(坏)的方向发展。就比如说,我们的机器学习算法一开始会给赋值,根据这些值以及x,我们可以计算出,但是这个很显然并不是一个正确的答案(因为我们的是假设的),那么,下一步算法就应该更新这个,使得,更加靠近.如何更新呢(是将a变大或者变小,将b变大或者变小)?
因为我们要使每一对
也就是
\begin{align}ax_i+b - y_i\to0\tag{6}\end{align}
现在是我们已知的数据,是机器自己选的,如何让a,b变换使呢,我们可以构造一个损失函数,均方误差
\begin{align}L(a,b) = 1/n\sum_{i=1}^{n}(y_i - (ax_i+b))^2\tag{7}\end{align}
注意:对于损失函数的要求:
-
可微性:损失函数需要是连续可微的(至少在大多数区间内)。这是因为大多数优化算法(如梯度下降)需要计算损失函数的梯度或偏导数,以更新模型的参数。
-
凸性:对于许多优化问题,损失函数最好是凸函数,这样可以保证局部最优解就是全局最优解,从而提高优化的稳定性和效率。
- 凸函数: 满足二阶导数非负或满足凸性定义的函数。
注意: 非凸损失函数(如深度学习中的交叉熵)可能会有多个局部最优,但仍然可以通过现代优化算法(如随机梯度下降)取得较好的结果。
-
能够量化误差:损失函数的定义应该能够准确反映模型输出与目标值之间的差距。
-
可解释性:损失函数的输出值应该有明确的物理意义或数学意义,便于调试和评估模型的表现。
-
鲁棒性:损失函数应对异常值(Outliers)具有一定的鲁棒性。在某些情况下,需要对异常值进行特殊处理,以避免其对损失的影响过大。
接下来我们需要让尽可能小就满足(6)中的需求。很显然是一个正数,这就成了求最小值的问题。这个时候提出另一种概念:梯度下降。
梯度:表示目标函数在参数的位置的变化率。具体来说,梯度指向函数增长最快的方向,其大小表示增长的速率。
对于一个连续可微的函数,在沿梯度方向是函数值改变最快的方向,那么梯度的负方向就是函数值下降最快的方向。梯度计算公式
算法过程:
-
构造损失函数:
\begin{align}L(a,b) = 1/n\sum_{i=1}^{n}(y_i - (ax_i+b))^2\tag{7}\end{align}
-
计算梯度:
-
更新参数:
,注意是负的,要找到函数下降最快的地方。
-
迭代:
\begin{align}L(a,b) = 1/n\sum_{i=1}^{n}(y_i - (ax_i+b))^2\tag{8}\end{align}
-
迭代终止:
迭代终止有以下几种方式:
-
最大迭代次数:
- 设置更新的最大次数,在达到这个次数之后就停止更新参数。
-
损失函数的变化量:
- 监控损失函数 L(a,b)L(a, b)L(a,b) 的变化,当连续两次迭代的损失变化量小于某个阈值 时,认为收敛并停止优化。典型值 。
-
梯度的范数:
- 梯度的范数(即梯度向量的大小)表示当前参数更新的幅度。当梯度的范数小于某个阈值 时,认为梯度接近零,函数已经接近最优值。
-
结合多种终止条件
-
该算法的完整代码(线性回归):
import numpy as np

# 数据输入
x = np.array([1, 2, 3, 4, 5])  # 输入特征
y = np.array([2, 4, 6, 8, 10])  # 目标值

# 超参数初始化
alpha = 0.01  # 学习率
max_epochs = 1000  # 最大迭代次数
epsilon = 1e-6  # 损失变化量阈值
delta = 1e-6  # 梯度范数阈值

# 参数初始化
a = 0.0  # 权重
b = 0.0  # 偏置
n = len(x)  # 样本数量

# 初始化终止条件
previous_loss = float('inf')  # 上一次的损失值

# 梯度下降循环
for epoch in range(max_epochs):
    # 预测值
    y_pred = a * x + b

    # 计算损失函数(均方误差)
    loss = np.mean((y - y_pred) ** 2)

    # 梯度计算
    da = -2 / n * np.sum(x * (y - y_pred))  # 对a的偏导
    db = -2 / n * np.sum(y - y_pred)        # 对b的偏导

    # 计算梯度范数
    grad_norm = np.sqrt(da ** 2 + db ** 2)

    # 更新参数
    a -= alpha * da
    b -= alpha * db

    # 输出迭代信息
    print(f"Epoch {epoch+1}, Loss: {loss:.6f}, a: {a:.6f}, b: {b:.6f}, Gradient Norm: {grad_norm:.6f}")

    # 检查终止条件
    if abs(previous_loss - loss) < epsilon:
        print(f"Converged due to small loss change at epoch {epoch+1}.")
        break
    if grad_norm < delta:
        print(f"Converged due to small gradient norm at epoch {epoch+1}.")
        break

    # 更新上一轮的损失值
    previous_loss = loss

# 最终结果输出
print(f"Final Parameters: a = {a:.6f}, b = {b:.6f}")
print(f"Final Loss: {loss:.6f}")

print(f"a: {a:.6f}, b: {b:.6f}")


import matplotlib.pyplot as plt

# 绘制散点图(真实值)
plt.scatter(x, y, color='blue', label='Actual Data')

# 绘制拟合直线(预测值)
y_fit = a * x + b
plt.plot(x, y_fit, color='red', label='Fitted Line')

# 图形细节
plt.xlabel('x')
plt.ylabel('y')
plt.title('Linear Regression with Gradient Descent')
plt.legend()
plt.show()
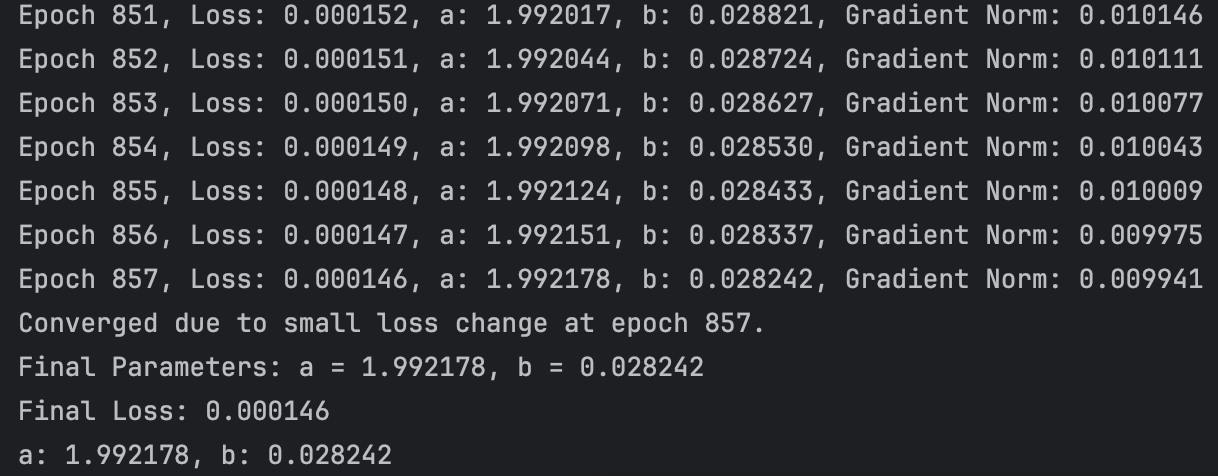
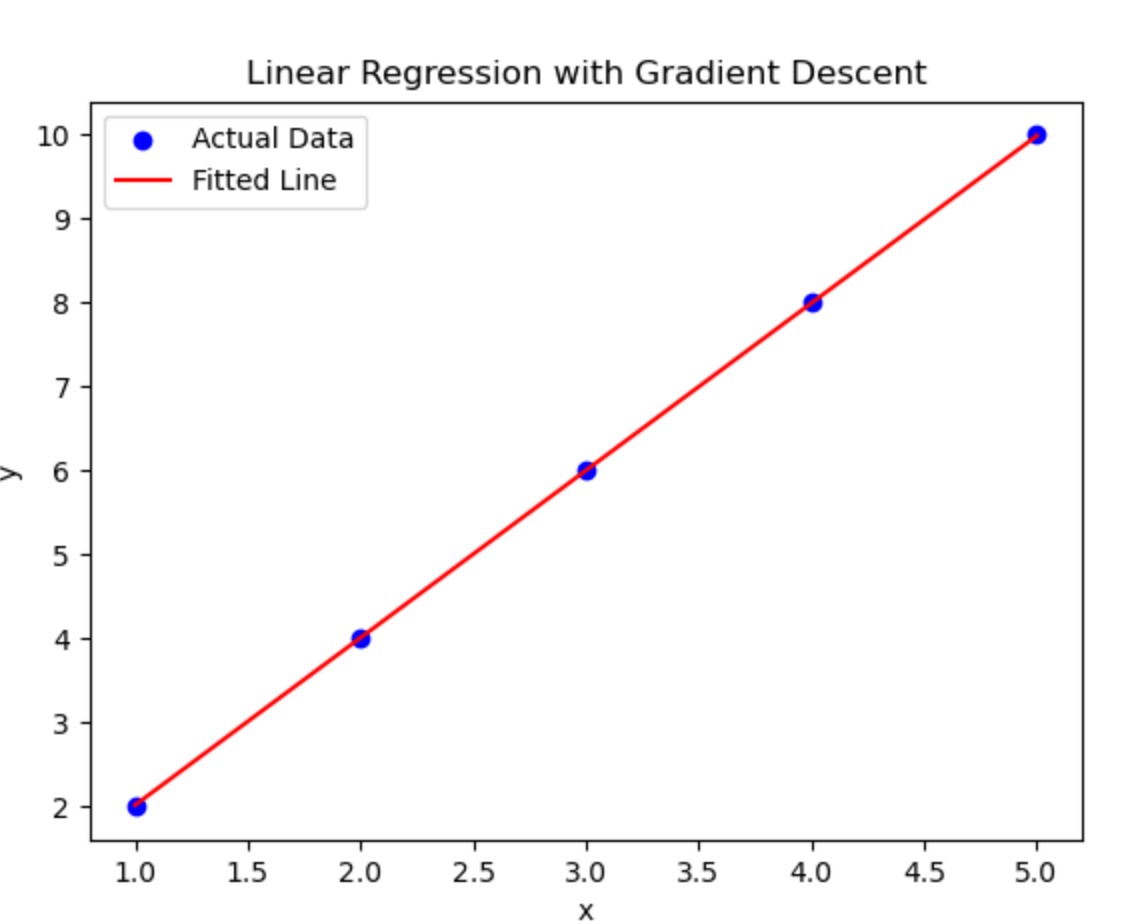
这里展示的是一种简单的线性回归算法,评估指标采用MSE(均方差),针对这个问题 我们的方法得到了比较好的计算结果,涉及到了两个参数:。
数据集: 类似于数据库,是一堆数据记录的集合,一般的算法都是根据你的输入经过算法处理得到输出。对于机器学习算法,我们的输入就是数据集。
训练集:数据集中用于训练算法,调整参数的数据,称为训练集。
测试集:数据集中用于测试算法优劣的数据,称之为测试集。
标量: 实际上就是我们说的常数,就是一个数值。
张量(Tensor): 在机器学习中n维数组称为张量,一维数组也叫做向量,二维数组称为矩阵。注意向量有自己的维度,向量的维度指的是向量大小或者长度,比如向量的维度是2,向量的维度是3。现流行的各种python机器学习,深度学习框架都对张量的计算有很好的处理。比如Tensorflow,Pytorch可以通过GPU,CPU加速计算。接下来的笔记,我尽可能去揭示每种算法的原理,包括图神经网络等。
数据预处理: 针对我们研究的问题,以及我们采用的算法,对我们的数据是有一定的格式要求的,比如深度学习算法只能处理数字,矩阵这样的数据。这样如果我们需要利用这个算法去完成翻译,语音识别,或者图片识别这样的任务我们需要把我们的要处理的文本,视频,音频转换成一定格式的数字数据。这个过程叫做数据预处理,这基本是每个算法使用前都要经历的过程。我很讨厌这个过程,他会耗费很多的时间。所以一般情况下我们就采用公开的有用的数据集合,而这些数据集又是被前人实验过的,应该是相当有用。python中的Pandas包以及Numpy包很适合帮助我们处理数据。
损失函数:针对问题,我们的解决方案要有一个衡量优劣的指标,计算这个指标的公式是损失函数 。期望和方差等都可以作为损失函数。
以方差为例
待补充。。。
机器学习常见算法
线性回归
- 概念:
尺素
0 封尺素
正在取尺素...